Heute legt arXiv drei Preprints vor, die Modelle an festen Maßstäben messen statt aneinander. Ein Zutaten-Test stellt 27 Sprachmodelle auf dieselbe Aufgabenliste, darunter Grok 4.6 von xAI, GPT-5.6, Gemini und Claude. Ein zweites Papier prüft, ob offene Modelle sagen können, dass ihre eigene Rechnung verändert wurde. Ein drittes steuert ein Endoskop vor und zurück, obwohl das Kamerabild gleich bleibt.
27 Modelle, ein Bewertungsprogramm als Maßstab
Josef Chen und Erim Hayretci (Imperial College London) stellen FlavourBench vor. Jede Aufgabe zeigt acht Zutaten. Das Modell soll drei auswählen: als Ersatz für eine Zutat, als Beilage oder unter Ernährungs- und Verarbeitungsgrenzen. Bevor irgendein Modell antwortet, bewertet ein festgeschriebenes Programm namens Epicure alle 56 erlaubten Dreierkombinationen. Die Antwort bekommt eine Punktzahl von 0 bis 100. Kein Mensch und kein Sprachmodell sitzt als Schiedsrichter dazwischen.
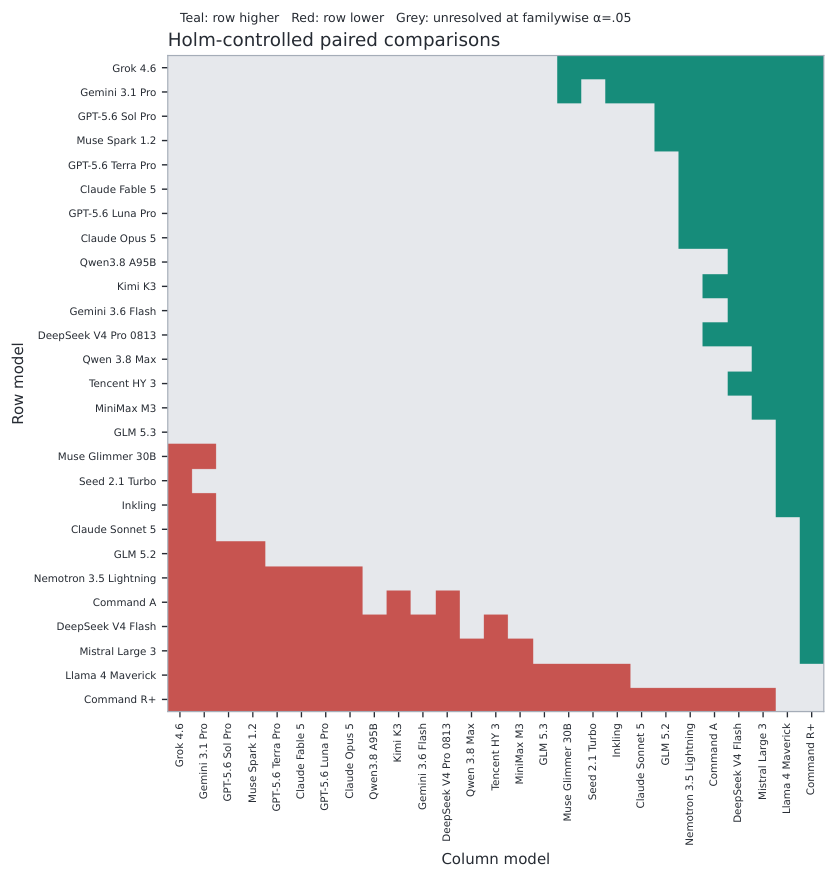
Alle 27 Modelle lösen dieselben 534 Aufgaben. Grok 4.6 hat den höchsten Schätzwert mit 65,1 Punkten (gleichzeitiges 95-Prozent-Intervall 61,0–69,2). Direkt dahinter liegen Gemini 3.1 Pro mit 65,0 und GPT-5.6 Sol Pro mit 64,2. Die Intervalle überlappen. Die Autoren schreiben, dass die Daten keinen statistisch eindeutigen Sieger ausweisen. In derselben vorderen Gruppe stehen unter anderem Metas Muse Spark 1.2, Anthropics Claude Fable 5 und Claude Opus 5, Qwen 3.8, Kimi K3 und DeepSeek V4 Pro.
Von 351 paarweisen Vergleichen bleiben nach Korrektur 101 signifikant. Llama 4 Maverick und Cohere Command R+ liegen klar darunter. Der Test misst Übereinstimmung mit Epicure, nicht allgemeine Intelligenz und nicht, ob Menschen die Kombination schmackhaft fänden. Code und Aufgaben stehen auf GitHub.
Das Signal sitzt in den Schichten, nicht in der Antwort
Emilio Ferrara fragt in Open-Weight Masked Introspection, ob Modelle berichten können, dass ihre eigene Rechnung verändert wurde. Die Forscher greifen in offene Modelle ein – an einzelnen Rechenstellen, Aufmerksamkeitseinheiten oder gelernten Merkmalen – und fragen danach, ob etwas passiert ist. Vergleichsbedingungen sind Scheineingriffe, bei denen nichts geändert wurde, und ein Beobachter, der nur den sichtbaren Text sieht.
Über 78.000 Messungen an acht Modellen aus sieben Familien: Die verbale Auskunft trennt echten Eingriff und Scheineingriff nicht besser als Zufall. Die Information ist trotzdem da. Ein lineares Lesegerät auf denselben Aktivierungen erkennt den Eingriff mit 75 bis 95,8 Prozent Trefferquote. Ein extra nachtrainiertes Modell trifft fast perfekt. In einem Modell bleibt die Ja-Nein-Antwort immer gleich, während die angehängte Sicherheit den Eingriff schwach anzeigt. Aufsicht, die nur die Selbstauskunft liest, liest den falschen Kanal. Die Software liegt auf Hugging Face. Modelle, deren innere Gewichte nicht öffentlich sind, fehlen in diesem Test, weil man in ihre Schichten nicht eingreifen kann.
Dasselbe Bild, entgegengesetzte Richtung
Bei einer Darmspiegelung fährt das Gerät erst vor, später zurück. Der Befehl „jetzt zurück“ kann kommen, bevor sich das Kamerabild ändert. Pixel allein reichen dann nicht. Ein Team der Chinese University of Hong Kong nennt das in EndoLIFT so: dieselbe Beobachtung verlangt zwei entgegengesetzte Bewegungen, je nach Auftrag.
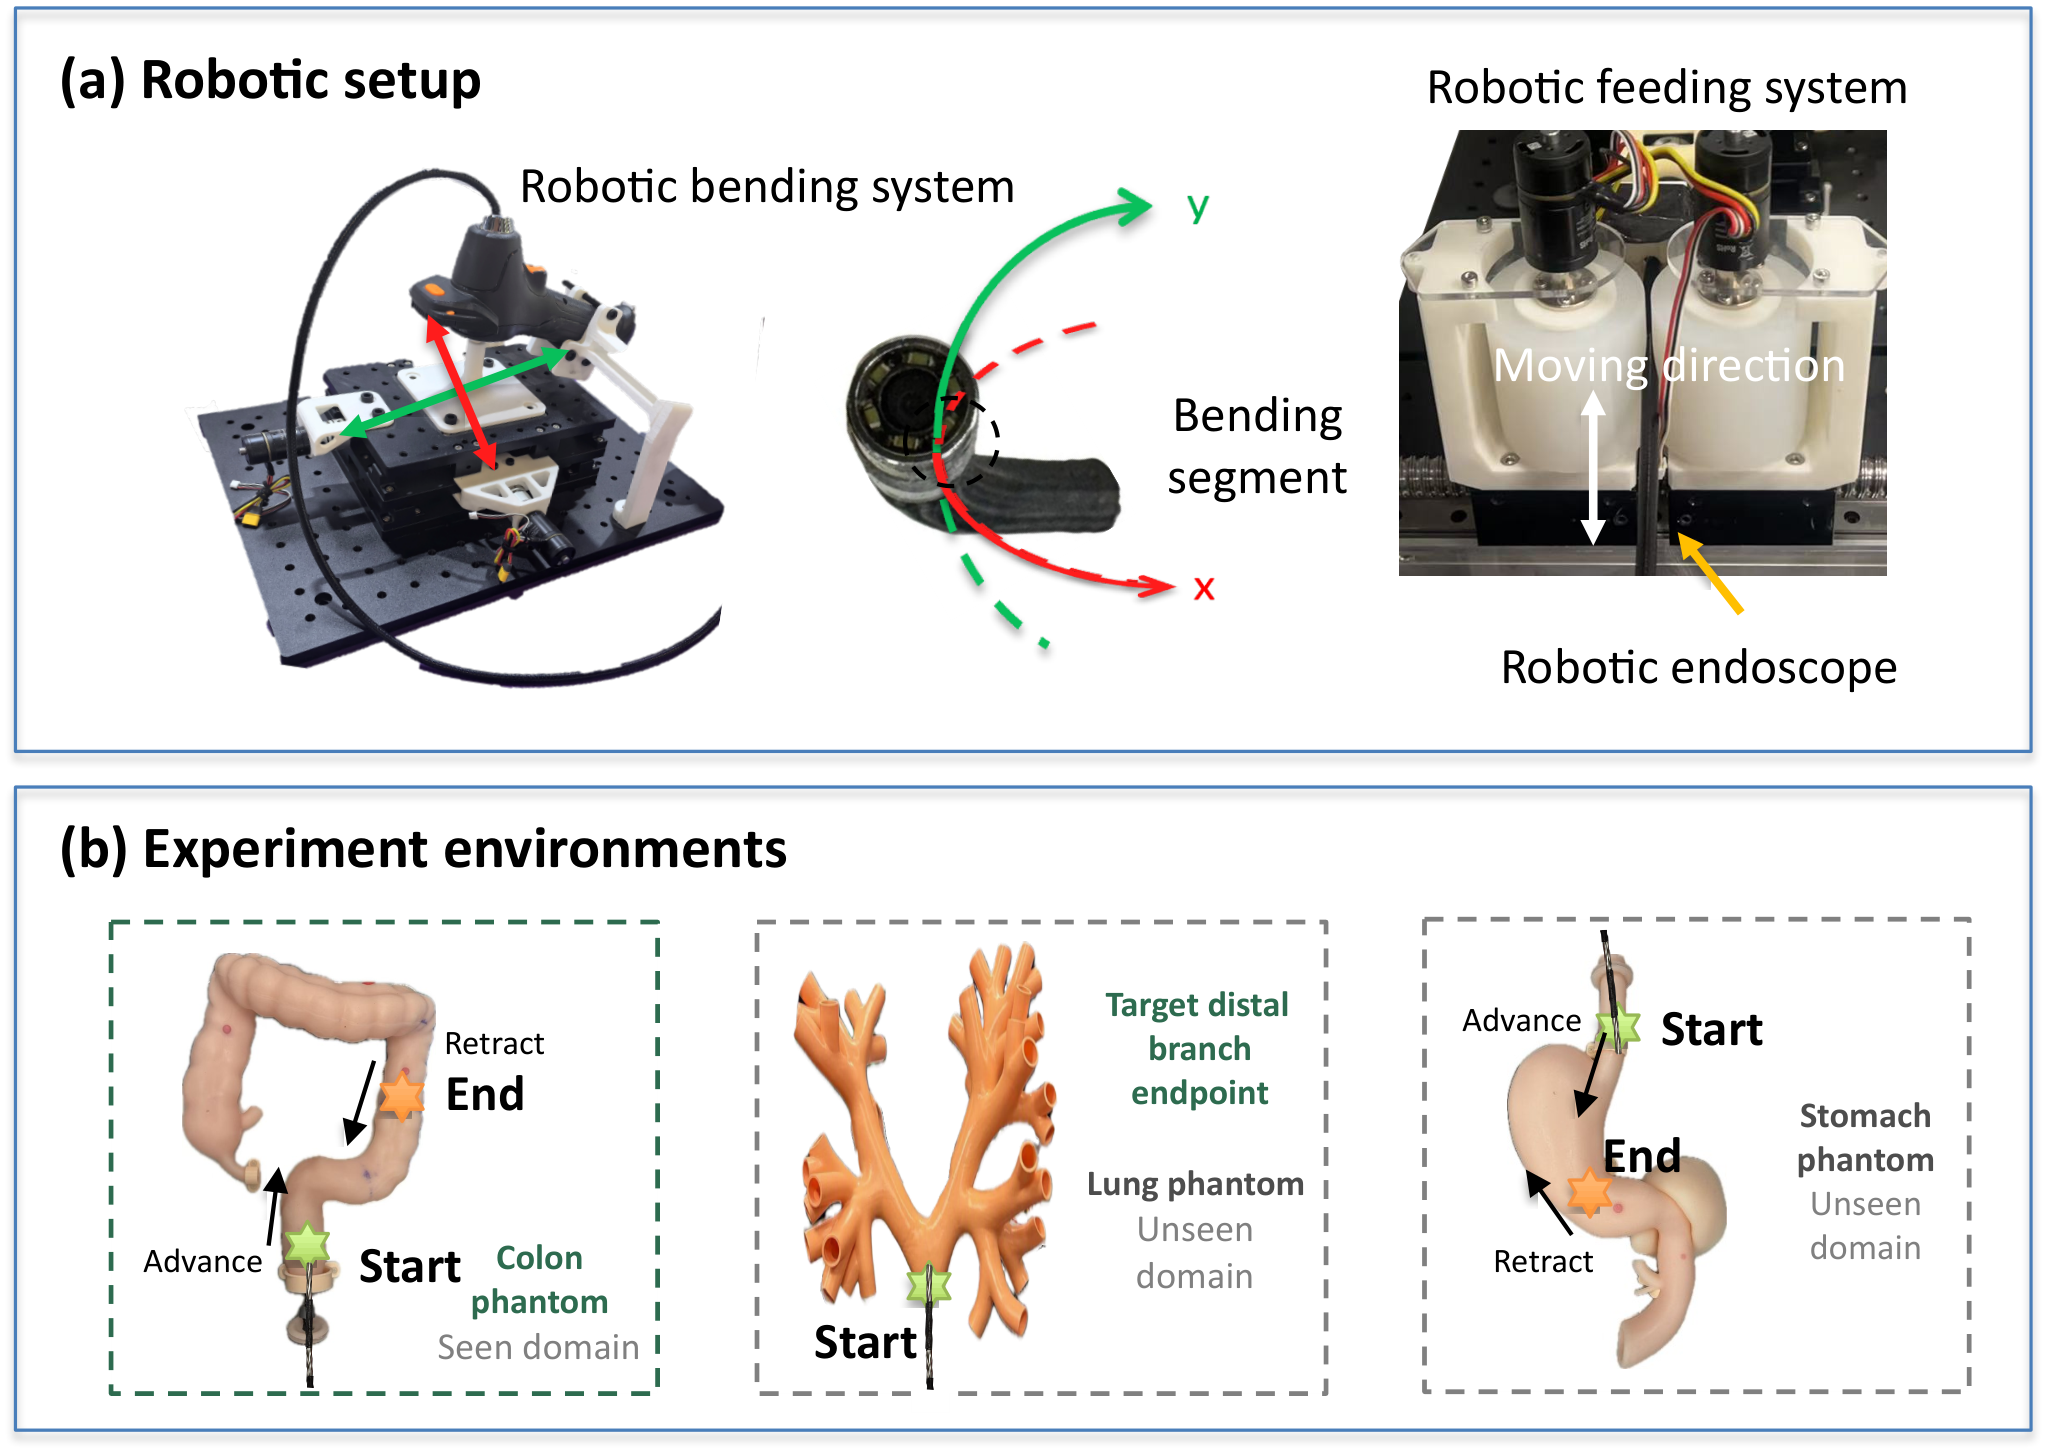
Das Steuerungsmodell bekommt das Bild, einen Sprachbefehl und die letzte Bewegung. Ein Bild-Sprach-Modell liefert den Kontext, ein zweites Netz erzeugt die Motorwerte. Gegenüber derselben Architektur ohne den zusätzlichen Bewegungsverlauf steigt die Trefferquote für die Fahrtrichtung um 11,1 Punkte. Falsches Weiterfahren beim Rückzug sinkt um 83 Prozent. In Kunststoffmodellen von Dickdarm, Lunge und Magen und in zehn Versuchen an einer Schweinelufttröhre zieht das System nach dem Rückzugsbefehl zuverlässig zurück. Die Autoren stufen das als begrenzte Aufgabenautonomie ein: Der Mensch setzt den Modus, das Gerät fährt, der Mensch kann jederzeit eingreifen. Eine klinische Zulassung folgt daraus nicht.
Bis bald
Euer Benny