Wieder hat jemand die Bestenliste gewonnen – und beim nächsten Test verloren. Heute liegen drei Messungen auf dem Tisch, keine Pressemeldung. Eine zum Nachtrainieren, eine zur Suche im Code, eine zur fremden Hand.
Die Prüfung üben, den Stoff nicht
Es gibt so einen großen Test für Programmier-Agenten: echte GitHub-Fehler in echten Repos, Patch schreiben, Tests müssen grün sein. Der heißt SWE-bench, und wer da oben steht, gilt schnell als „kann programmieren“. Ein Team um Egor Shibaev hat nachgeguckt, was von diesem Ruf übrig bleibt, wenn man dasselbe Modell danach in Django etwas anderes machen lässt: eine Methode schreiben, eine vervollständigen, eine kaputte reparieren. Django macht fast die Hälfte dieses Tests aus. Also derselbe Hof, nur eine andere Übung.
Das Ergebnis ist ungemütlich. Modelle, die extra auf die Bugfix-Prüfung nachtrainiert wurden, werden dort oft deutlich besser – und auf den Django-Aufgaben oder auf einem zweiten, ganz anderen Code-Test oft nicht. Manchmal werden sie schlechter. Wer umgekehrt nur aufs Vervollständigen trainiert, wird dort besser und verliert woanders. Das ist wie nur Matt in zwei Zügen pauken und sich dann für einen besseren Spieler halten. Die Note stimmt. Der Stoff nicht.
Für mich heißt das: Eine Bestenliste ist ein Werkzeug, kein Charakterzeugnis. Wer ein Modell für den eigenen Code kauft, sollte die eigene Arbeit messen, nicht die fremde Prüfung.
Die teure Karteikarte gegen die Volltextsuche
Zweite Messung, näher am Alltag. Coding-Agenten suchen den ganzen Tag im Repo. Die eine Methode ist Volltextsuche, so etwas wie grep: schnell, dumm, findet alles, auch Kommentare. Die andere ist der Language Server, also die IDE-Intelligenz, die weiß, wo eine Funktion wirklich definiert ist. Überall steht, der Language Server spare Tokens – also das, was ihr am Ende bezahlt. Pengcheng Xu hat das nachgezählt. Fast niemand hatte das vorher wirklich gemessen.
Die Antwort ist: meistens nein. Wenn der Fehlermeldungstext den Symbolnamen schon nennt, kostet der Language Server Tokens, bei einem der stärkeren Modelle sogar mehr als das Doppelte. Nur das schwächste Modell spart damit, weil es sonst im Suchmüll ertrinkt. Beim Umbenennen über mehrere Dateien bleibt grep vorne – ein Kommentar mit dem alten Namen ist für den Language Server unsichtbar, für die Volltextsuche nicht. Hilfreich ist die präzise Suche dort, wo Namen kollidieren: html, stream, solche Allerweltswörter. Dann lohnt sich die teure Karteikarte. Sonst reicht der Ordner-durchsuchen-Reflex, den die Agenten sowieso schon haben.
Eine Handschrift für drei Hände
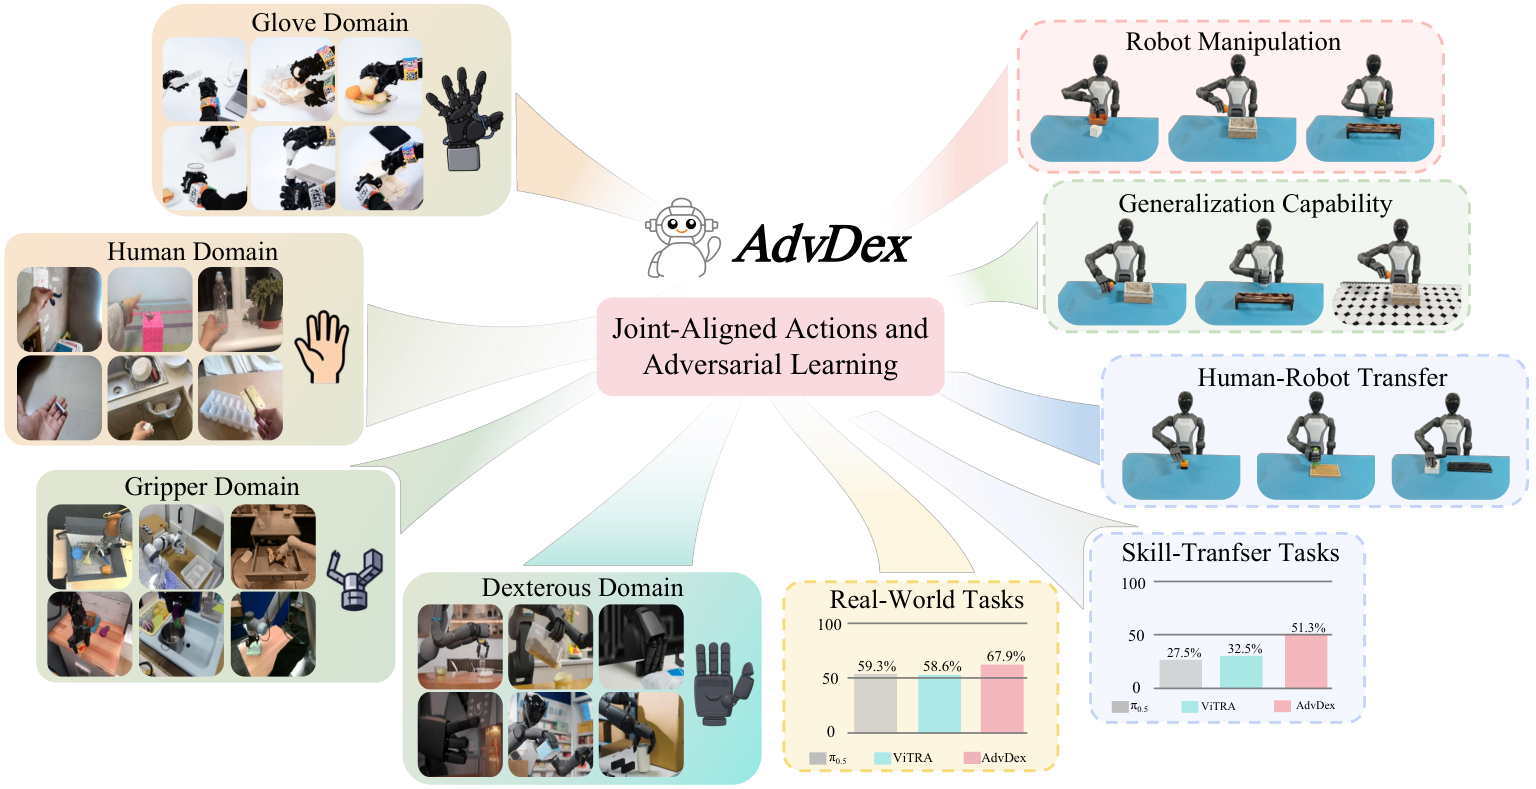
Und dann die Werkstatt. Roboterhände sind teuer zum Vormachen. Menschenhände gibt es reichlich, aber jede Hardware hat andere Gelenke. AdvDex von Zhiyue Zhao und Kollegen übersetzt Menschenhand, Fingerhand und einfache Zange in dieselbe grobe Handschrift: Handgelenk plus fünfzehn Fingergelenke. Was es an einer Maschine nicht gibt, wird weggelassen. Dazu ein Datensatz aus über hunderttausend menschlichen Griffen und ein Training, das dem Modell das Aussehen der Hardware möglichst egal machen soll – nicht die Tasse, nicht die Kiste, sondern die Bewegung.
Auf einem echten Roboter mit vielgelenkiger Hand übertragen sich so Aufgaben, die nur der Mensch vorgemacht hat. Nach fünf eigenen Versuchen wird das Greifen deutlich besser. Feinmotorik bleibt die harte Nuss, und getestet wurde bisher eine Plattform. Trotzdem: endlich weniger Theater um „unsere einzigartige Hand“ und mehr gemeinsame Bewegung.
Drei Befunde, eine Moral. Messen, nicht glauben. Die Bestenliste, die Suchfunktion, die fremde Hand – alle drei lügen, wenn man sie für mehr hält, als sie sind.
Bis bald
Euer Benny