Drei Preprints vom Freitag, 4. September 2026, messen, wie wenig Daten ein Sprachmodell nach dem Vortraining noch braucht – und wie viel ein Roboter mit zwei Armen für Haushaltstätigkeiten braucht. Ein offener 88-Zentimeter-Humanoid schließt den Überblick.
Eine Übungsaufgabe statt 17.000
Beim Nachtraining lernt ein kleineres Modell von einem größeren, indem es selbst Antworten schreibt. Das größere Modell bewertet nicht nur das Endergebnis, sondern jedes einzelne Wort. Tsinghua und Partner prüfen in arXiv:2609.04172, was passiert, wenn man dafür nur eine Übungsaufgabe nimmt – 64 Versuche pro Schritt, über Hunderte Schritte.
Auf drei Mathematiktests erreicht dieses eine Beispiel 68,5 Punkte, das volle Datenset mit 17.000 Aufgaben 69,8. Das ist 87 Prozent des Gewinns. Eine Aufgabe deckt bereits 71,5 Prozent der Denksituationen ab, die das volle Training besucht; 16 inhaltlich verschiedene Aufgaben kommen auf 98,9 Prozent und ziehen mit dem vollen Set gleich. Der Engpass ist nicht die Datenmenge: Das Schüler-Modell nimmt die Korrekturen des Lehrers mit der Zeit immer langsamer auf, egal ob es eine Aufgabe oder alle 17.000 sieht. Der Effekt hält über Mathematik, Code, Anweisungen und Werkzeugnutzung sowie über drei Modellfamilien.

1500 Stunden Haushalt, dann Eingriffe am Gerät
Peking und PrimeBot legen in arXiv:2609.03591 1500 Stunden Zwei-Arm-Daten frei: 532 Stunden Fernsteuerung auf dem fahrbaren Roboter X2W (32.518 Trajektorien, Wäsche falten, Waschmaschine, Sofa, Wäschekorb) plus rund 1000 Stunden mit handgeführten Greifern in über 200 Haushalten. Darauf trainieren sie XR-2, ein 5-Milliarden-Parameter-Modell, das Kamerabild, Sprachbefehl und Gelenkzustand in Bewegungen übersetzt.
Beim Falten steigt die Erfolgsrate mit mehr Expertendaten von 34 Prozent bei 30 Stunden auf 84 Prozent bei 120 Stunden; 160 Stunden bringen nichts mehr (82 Prozent). Was fehlt, sind Zustände, die nur das trainierte Modell selbst erzeugt. Drei Runden menschlicher Korrektur während des Laufs heben die Rate von 58 auf 93 Prozent. Datensatz und Roboterbeschreibung stehen auf Hugging Face.

Körper und Steuerung gemeinsam entworfen
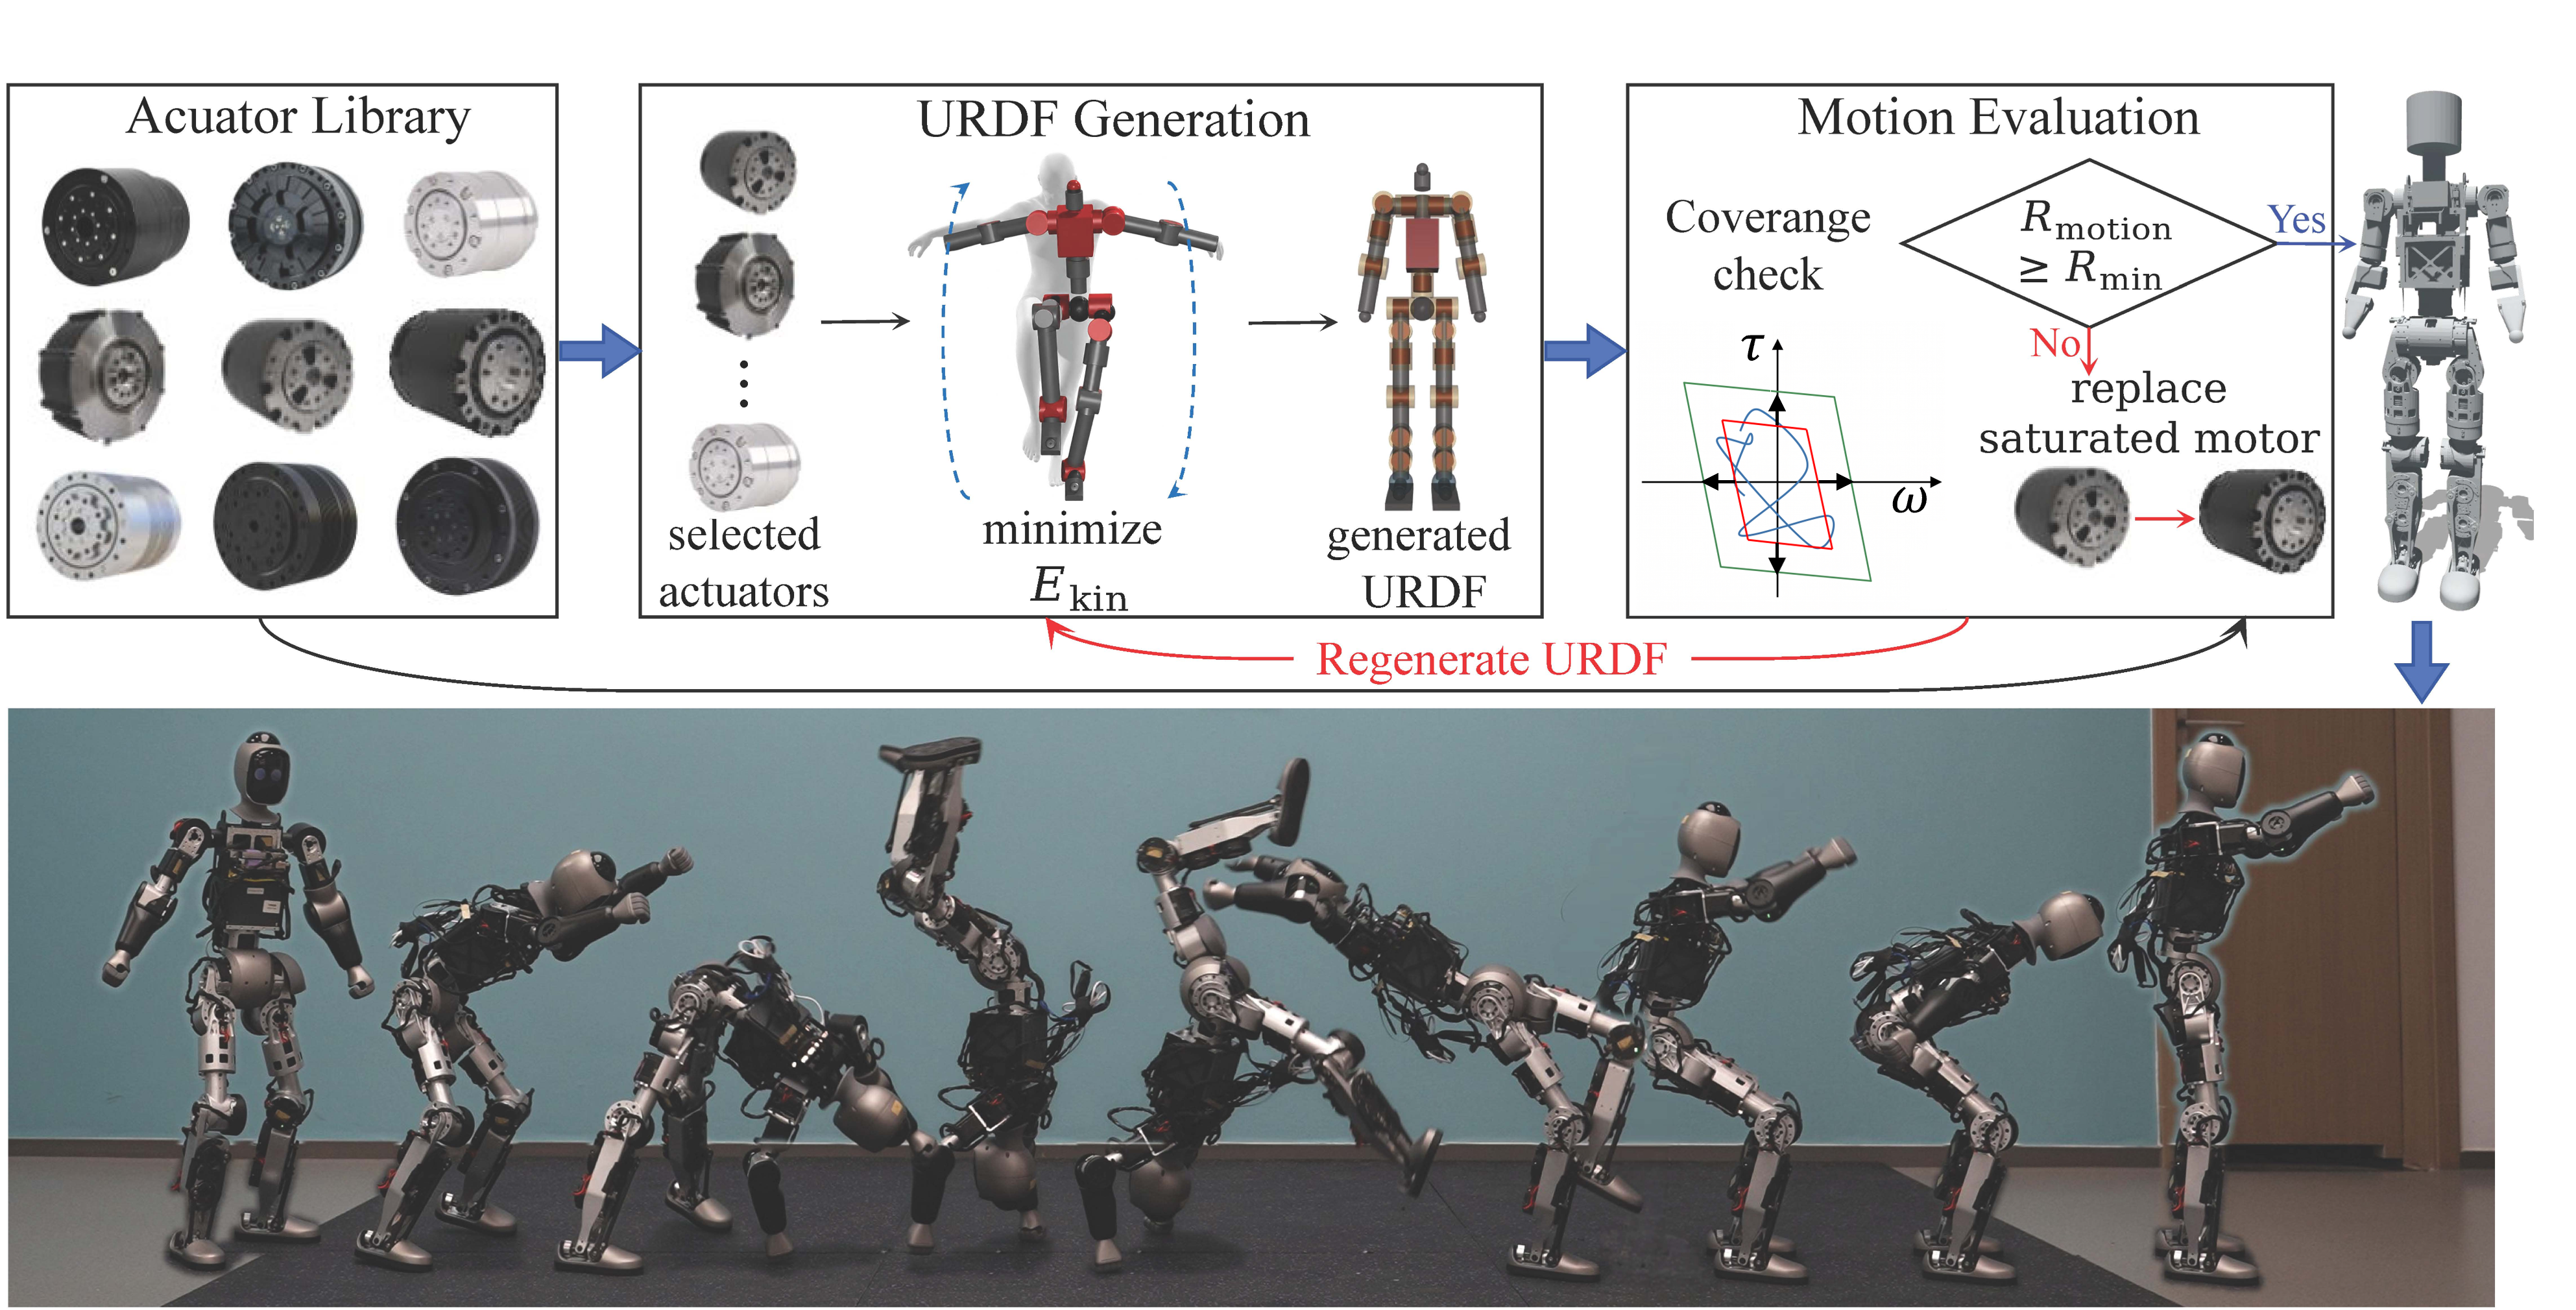
Carnegie Mellon, HUST und JoyIn AI beschreiben in arXiv:2609.03497 Bridge: 88 Zentimeter, rund 13 Kilogramm, 21 aktive Gelenke, Steuerung und Konstruktionsdaten offen. Bauform und Steuerung wurden gemeinsam optimiert, damit menschliche Bewegungsdaten möglichst treu auf den Roboter passen. Gegen Bumi, K1 und ToddlerBot liegt Bridge bei Nachahmungsgüte und Bewegungsfehler vorn; in der Simulation schafft es 94,8 Prozent der Testbewegungen (Balance, Alltag, schnelle Manöver). Videos und Material: Projektseite.
Die drei Arbeiten sind Preprints, keine begutachteten Journalartikel. Das Nachtraining gilt für Modelle in der Größenordnung 1,5 bis 7 Milliarden Parameter, nicht für die größten Systeme. Die Haushaltsversuche laufen auf einer Roboterfamilie; Bridge ist klein und für schwere Manipulation nicht ausgelegt.
Bis bald
Euer Benny
Quellen
- Fu, He et al.: Rethinking On-Policy Distillation of Large Language Models II: One Training Example, arXiv:2609.04172
- Dieselbe Arbeit, HTML mit Figuren
- Xu, Li et al.: Scaling Bimanual Household Manipulation from 1,500 hours of Demonstrations, arXiv:2609.03591
- XR-2-Datensatz auf Hugging Face
- Wang, Qian et al.: BRIDGE: An Open-Source Humanoid Platform, arXiv:2609.03497
- Bridge-Projektseite