Drei neue arXiv-Arbeiten vom 20. August. Ein Steuerungspaket für humanoide Roboter nutzt Stühle und Stufen als Stütze. Ein Decoder rekonstruiert getippte Sätze aus Magnetfeldern des Gehirns. Kleine Sprachmodelle verfolgen Gegenstände in Geschichten schon bei 410 Millionen Parametern.
Stuhl und Stufe als Stütze
Die meisten Steuerungen für humanoide Roboter lernen auf ebenem Boden. Sitzt der Roboter, steigt er auf eine Kiste oder trägt er etwas Schweres, ändert sich die Dynamik. Bisherige Tracker behandeln solchen Kontakt oft als Störung.
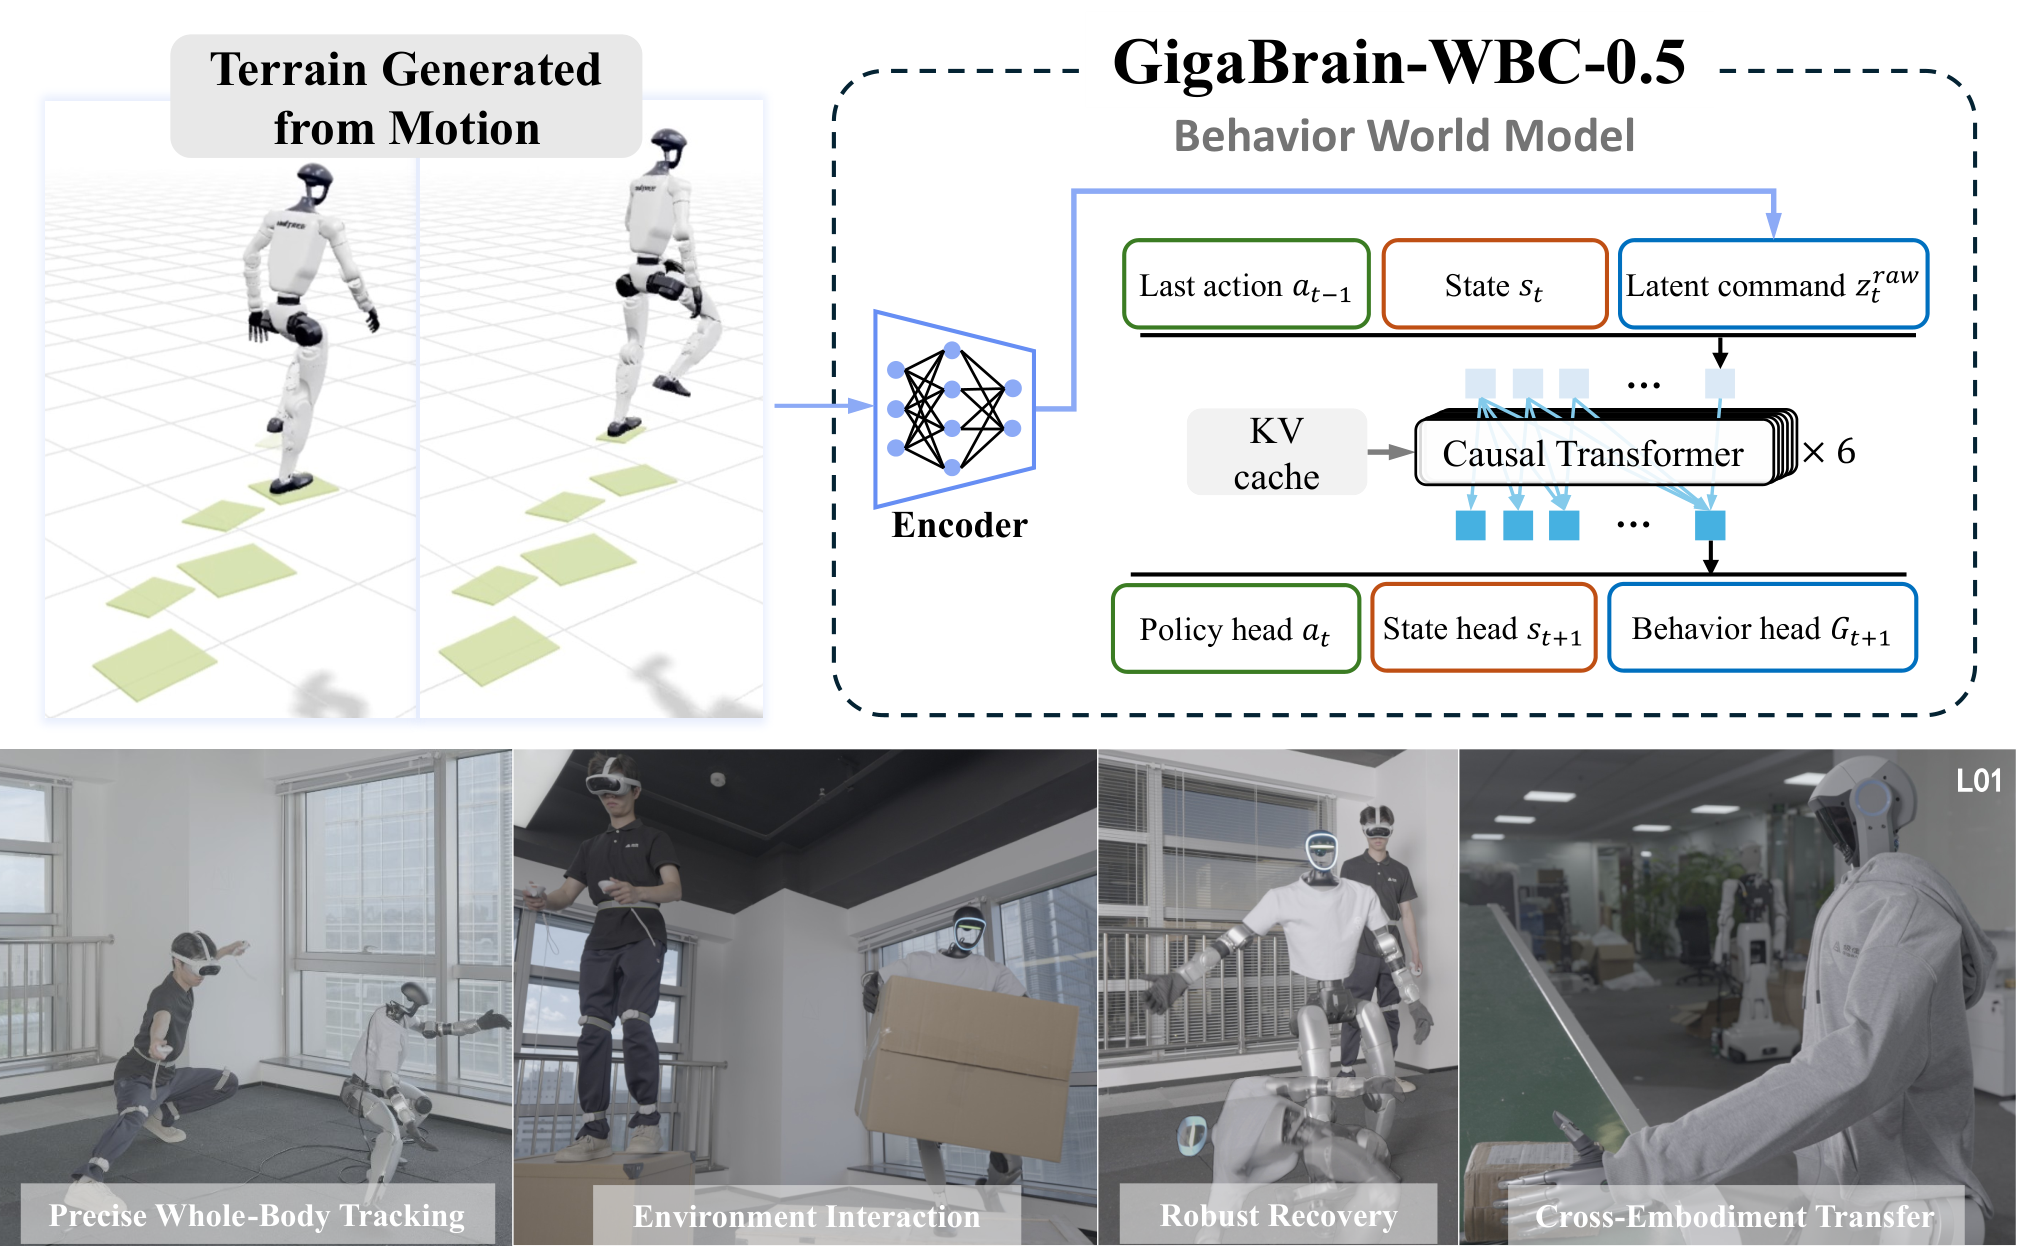
Ein Team von Tsinghua und GigaAI stellt mit GigaBrain-WBC-0.5 eine Steuerung vor, die beim Handeln mitlernt, was der Körper als Nächstes tun kann. Das Netz sagt den nächsten Gelenkbefehl voraus, den nächsten Körperzustand und eine Verteilung über zulässige Folge-Befehle. Liegt ein Kommando außerhalb des Gelernten, wird es auf die nächste ausführbare Bewegung zurückgezogen, statt den Roboter stehen zu lassen.
Geländedaten kommen aus vorhandenen Bewegungsaufnahmen. Eine Pipeline rekonstruiert aus Kontaktpunkten echte 3-D-Geometrie: Stufen, Sitze, Kisten, Tische. In der Simulation (MuJoCo) liegt die Erfolgsrate bei Geländekontakt bei 81,3 Prozent, 4,3-mal so hoch wie beim stärksten der drei Vergleichsmodelle SONIC, HoloMotion-1 und Humanoid-GPT. Aus liegender Startlage steht das Modell in 99,3 Prozent der Fälle wieder auf; die Vergleichsmodelle bleiben unter 6 Prozent. Hardwareversuche am Unitree G1 zeigen qualitativ: Sitzen auf einer Kiste, Aufsteigen auf eine Plattform, Heben eines 2-Kilogramm-Feuerlöschers. Derselbe gespeicherte Stand der Steuerung lässt sich mit kurzem Nachtraining auf den Maker L01 übertragen.
Die Zahlen zum Gelände und zum Aufstehen stammen aus der Simulation. Die Hardwareversuche sind Gegenüberstellungen unter demselben Live-Kommando, keine große statistische Serie. Die Autoren kündigen weitere Messungen an.
Sätze aus Magnetfeldern
Brain2Qwerty v2 von Meta, der École normale supérieure und dem Basque Center on Cognition, Brain and Language liest getippten Text aus Magnetenzephalografie: Sensoren messen die Magnetfelder, die das Gehirn erzeugt, ohne Implantat. Neun gesunde Personen tippten je zehn Stunden, zusammen 22.000 Sätze. Das Modell sieht den durchgehenden Signalverlauf einer ganzen Satzproduktion, nicht die einzelnen Tastenanschläge.
Im Mittel liegt die Wortfehlerrate bei 39 Prozent: 39 von 100 Wörtern sind falsch, fehlen oder sind überzählig. Beim besten Teilnehmer sind 47 Prozent der Sätze mit höchstens einem Wortfehler rekonstruiert, 28 Prozent fehlerfrei. Ein vorgeschaltetes Netz liest Buchstaben, ein zweites richtet Hirnsignal und Wortbedeutung aus, ein drittes erzeugt daraus mit einem Sprachmodell den Satz. Ohne die aus dem Hirnsignal abgeleiteten Worteinheiten wird das Ergebnis schlechter: Das Sprachmodell stützt sich nicht nur auf seine Textkenntnis.
Die Fehlerquote fällt mit mehr Aufnahmestunden log-linear und zeigt bei 90 Stunden noch keine Sättigung. Der Abstand zu Implantaten bleibt groß: dort liegen Wortfehlerraten beim Tippen unter 2 Prozent. Getestet wurden gesunde Tippende, keine Patientinnen oder Patienten. Das Modell wartet den ganzen Satz ab, es liefert also kein Wort, während jemand tippt.
Tracking schon unter einer Milliarde Parameter
Wer eine Geschichte versteht, merkt sich, wo Gegenstände sind, auch wenn das nicht extra steht. Frühere Tests mit künstlichen Kisten-Aufgaben sahen diese Fähigkeit erst in großen, code-lastig trainierten Modellen. Karolina Drożdż und Micha Heilbron prüfen dasselbe an kurzen, natürlich klingenden Erzählungen und vergleichen Modelle mit 48 Menschen.
Bei Menschen sinkt die Trefferquote mit der Zahl der Gegenstände und Orte, nicht mit der Textlänge: von 87,2 Prozent in der einfachsten offenen Abfrage auf 65,0 Prozent in der schwierigsten. Das Modell Pythia mit 410 Millionen Parametern erreicht bereits menschliches Niveau in der impliziten Variante, bei der nur Wahrscheinlichkeiten verglichen werden. Llama 3.3 (70 Milliarden Parameter) und Qwen 2.5 (72 Milliarden) bleiben über alle Schwierigkeitsstufen nahe der Obergrenze. Die Trefferquote ändert sich kaum, wenn Gegenstände durch Kunstwörter oder unplausible Objekte ersetzt werden.
Die Autoren selbst begrenzen die Aussage: Pythia und OLMo 2 enthalten Code im Trainingsmaterial. Ob Tracking ganz ohne Code entsteht, ist damit nicht geklärt. Der Test misst das Nachvollziehen von Objektorten in kurzen Geschichten, nicht beliebiges Weltwissen.
Bis bald
Euer Benny
Quellen
- Cheng et al.: GigaBrain-WBC-0.5, arXiv:2608.18234
- Projektseite GigaBrain-WBC-0.5
- GigaBrain-WBC-0.5 als HTML
- Zhang, Lévy et al.: Brain2Qwerty v2, arXiv:2608.18114
- Brain2Qwerty v2 als HTML
- Code zu Brain2Qwerty
- Drożdż, Heilbron: Entity tracking in sub-billion parameter models, arXiv:2608.18083
- dieselbe Arbeit als HTML