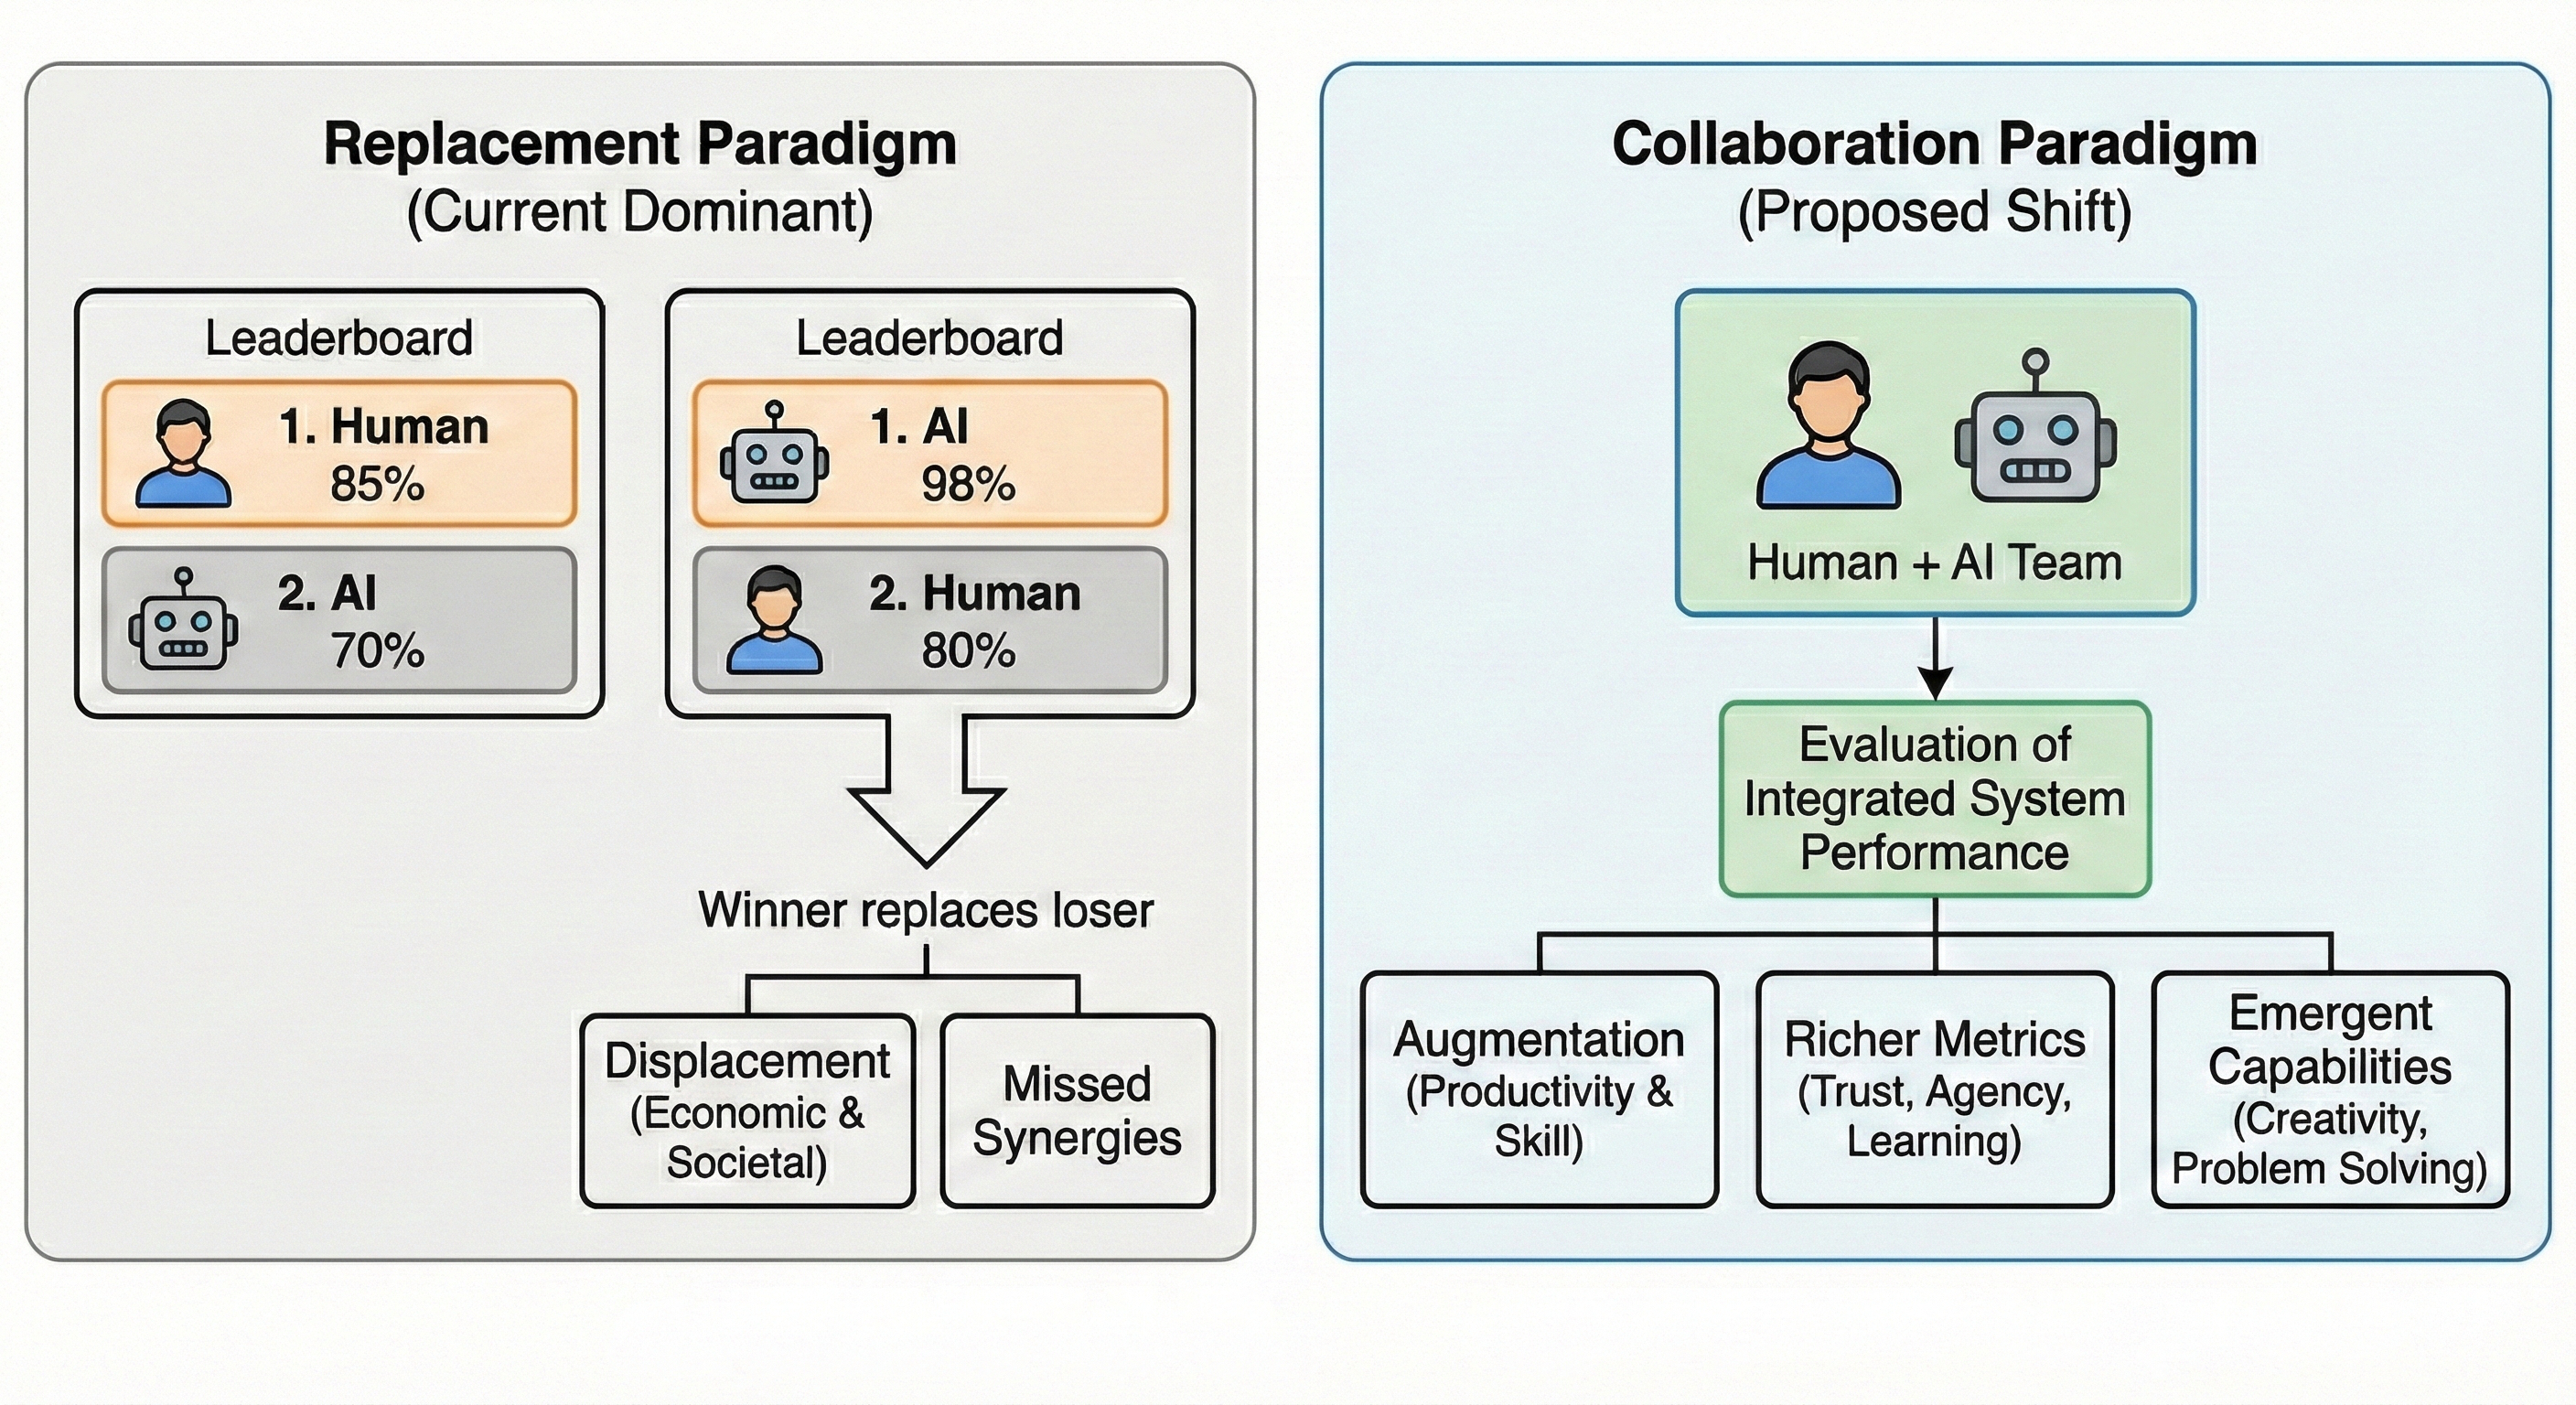
Die übliche Bestenliste in der KI-Forschung sieht aus wie ein Wettkampf: Hier der Mensch, dort das Modell. Wer besser ist, gewinnt. Und wer gewinnt, darf den anderen ersetzen. Ein Positionspapier für ICML 2026 von Jan Kulveit, Gavin Leech, Tomáš Gavenčiak und Raymond Douglas sagt: Genau diese Frage steuert die Entwicklung in die falsche Richtung.
Nicht weil Solo-Tests unsinnig wären. Autonomes Fahren muss auch allein funktionieren, das schreiben die Autoren ausdrücklich. Aber fast alle großen Benchmarks messen nur das: Kann das Modell die Aufgabe ohne uns? Daraus entsteht still eine Ersatz-Logik. Modelle lernen, sicher und vollständig zu antworten. Sie lernen weniger, nachzufragen, unsicher zu sein oder sich an einen Menschen anzupassen, der müde, ungeübt oder besser als sie ist.
Es gibt dazu schon unbequeme Befunde. Systeme, die allein glänzen, können im Team unbeholfen werden, weil niemand mehr vorhersagen kann, wann sie irren. Und in einer Studie zur Textarbeit half ein Modell Experten eher als Sparringspartner – als Ghostwriter wurde es schädlich, weil es die eigene Idee zu früh zementierte.
Der Vorschlag ist deshalb einfach, auch wenn er teurer ist: Nicht nur das Modell messen, sondern das Paar. Schafft Mensch plus Modell etwas, das keiner von beiden allein schafft? Bleibt der Mensch dabei handlungsfähig, oder gibt er die Steuerung ab? Die Autoren wollen Solo-Tests nicht abschaffen, sondern nach unten schieben: schnell und billig zum Vorsortieren. Für den Ernstfall soll gelten, was in der Praxis zählt – die gemeinsame Arbeit.
Wer Modelle nur danach züchtet, ob sie uns überholen, bekommt Ersatzteile. Wer sie danach züchtet, ob wir zusammen weiterkommen, bekommt Werkzeuge. Das ist kein Moralappell. Das ist die Frage, welche Bestenliste die nächste Generation formt.
Quellen
Bis bald
Euer Benny