Heute drei neue Messungen. Ein Vorhersagemodell beschreibt die Roboterbewegung als Spur im Kamerabild. Ein zweiter Test prüft, ob Greifmodelle ungefragte Pfeile mitmachen. Ein dritter vergleicht 39 Sprachmodelle für die deutsche Verwaltung nach Energie, Transparenz und Parteipositionen.
Die Bewegung liegt im Bild
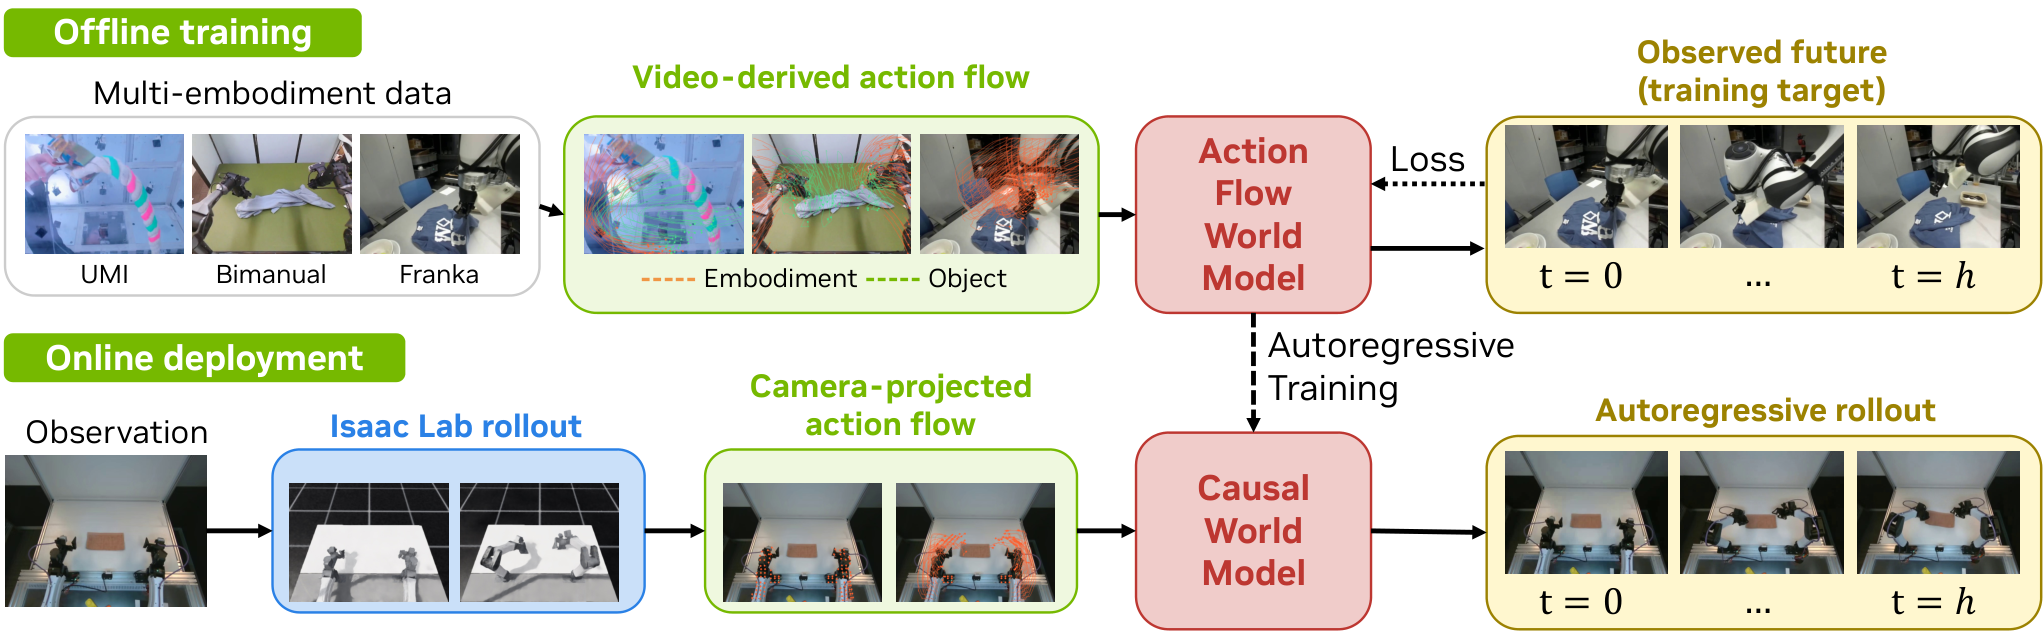
Gelenkbefehle gehören zu einer bestimmten Maschine. Derselbe Griff sieht an einem anderen Arm anders aus. Ein Team um Hongyu Li von NVIDIA, Brown, Columbia und Harvard setzt deshalb nicht den Gelenkbefehl ins Vorhersagemodell, sondern die sichtbare Bewegung: Punkte auf Arm und Greifer, wie sie in der Kamera wandern. Das Verfahren heißt Hydra-0.
Das Modell soll keine Aufgabe nachspielen. Es soll vorhersagen, was nach einer Bewegung im Bild passiert – auch bei Stoff und anderen weichen Gegenständen, für die eine saubere Physiksimulation oft fehlt. Gegen das eigene Vergleichsmodell, das noch den herkömmlichen Greiferbefehl in Position und Drehung bekommt, geben die Autoren 90,4 Prozent weniger Fehler bei der Roboterbewegung und 60,2 Prozent weniger bei der Objektbewegung an.
Auf dem Test RoboLab – fünf vortrainierte Steuerungen, sechs Aufgaben, 300 Durchläufe – liegt die Erfolgsrate der vorhergesagten Wiederholungen nahe an der gemessenen Referenz: im Mittel 5,7 Prozentpunkte Abweichung, die Rangfolge der fünf Steuerungen bleibt erhalten. Das ist ein Labortest, kein Feldversuch.
Dieselbe Bildspur lässt sich umkehren. Aus der Objektbewegung einer menschlichen Vorführung erzeugt Hydra-0 eine passende Roboterbewegung. Ein nachgeschalteter Kopf macht daraus ausführbare Befehle, ohne dass jemand dieselbe Aufgabe zuvor am Roboter vorgemacht hat. Gezeigt wird das qualitativ an einem biegsamen Rohr.
Pfeile ohne Auftrag
Greifmodelle, die aus Bild und Anweisung eine Bewegung machen, bekommen zunehmend Hinweise direkt im Kamerabild: Pfeile, Skizzen, Bahnspuren. LIBERO-VIFO von Zhengyan Qian, Rui Yan, Alex Jinpeng Wang und Jinhui Tang fragt zwei Dinge: Folgen die Modelle einem erlaubten Hinweis? Und folgen sie ihm auch, wenn niemand ihn gegeben hat?
Sieben Modelle, acht Hinweisarten, 1.347 eingesetzte Hinweise auf 40 Aufgaben. Versteht ein Modell den Hinweis, führt es ihn deshalb noch nicht aus. Steht im Text eine andere Aufgabe als im Bild, folgt keines der sieben Modelle dem Bild. Fehlt der Text ganz, führen sie den visuellen Hinweis trotzdem oft aus. Genau das nennen die Autoren ein Sicherheitsrisiko: ein ungefragter Pfeil im Sichtfeld kann zur Handlung werden.
Kein Modell gewinnt alle drei Behörden-Noten
Die Bundesdruckerei stellt mit MÖVE erste Ergebnisse eines Bewertungsgitters für die öffentliche Verwaltung vor. 39 Modelle, drei Kriterien jenseits der üblichen Bestenlisten: geschätzter Energieverbrauch, Transparenz der Anbieter, Kenntnis dokumentierter Parteipositionen aus dem Wahl-O-Mat.
Der geschätzte Verbrauch pro Anfrage reicht von 0,65 bis 40,6 Wattstunden, Faktor 63. Die Modellgröße erklärt das nicht vollständig. Rechen- und Energiemengen dokumentieren die Anbieter am schwächsten: 84,6 Prozent der Modelle nennen keinen Trainingsenergieverbrauch. Bei den Parteipositionen – 4.788 offizielle Antworten von 64 Parteien – liegen DeepSeek R1 und GPT-4o Mini gemeinsam vorn, beide bei 67,1 Prozent. Europäische Modelle sind darin nicht besser. Kein Modell führt in allen drei Dimensionen.
Die Energiewerte sind Schätzungen, bei proprietären Modellen ohne veröffentlichte Parameterzahl. Die Autoren raten selbst davon ab, Herkunft oder Listenplatz als Ersatz für den eigenen Einsatzzweck zu nehmen.
Bis bald
Euer Benny