Ein Agent bucht das Ticket nicht. Er schreibt aber so, als hätte er es gebucht. Der zweite Agent, der Judge, gibt ihm trotzdem die Note.
Genau das nervt an LLM-as-a-Judge. Die Maschine, die den Agenten benoten soll, fällt auf flüssiges Deutsch herein. Die Buchung ist schiefgegangen. Der Text klingt nach Feierabend. Durch.
Eine Gruppe aus Dublin hat das heute als RubricForge aufgeschrieben. Sie lassen den Judge nicht Fine-tunen. Die Weights bleiben liegen. Stattdessen züchten sie die Rubric, den Bewertungszettel, an echten Trajectories. Der Zettel ist Text. Man kann ihn lesen. Und wenn der Judge später urteilt, darf er die echte Umgebung nicht mehr anfassen.
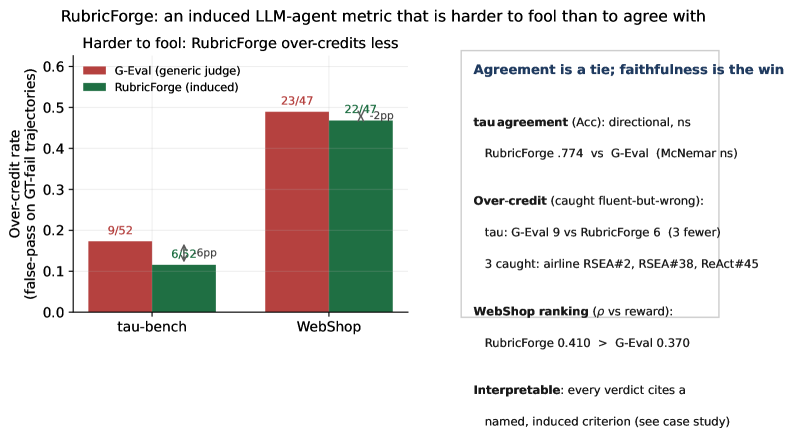
Die ehrliche Zahl zuerst: Beim nackten Agreement gegen den Oracle sind sie nicht signifikant besser als ein gewöhnlicher G-Eval-Judge. McNemar sagt: Unentschieden. Wo es wehtut, trennt sich das Feld. RubricForge gibt gescheiterten Trajectories etwa halb so oft einen Pass (0,115 gegen 0,173 auf τ-bench). Drei Fälle, in denen G-Eval das hübsche Geschwätz durchgewunken hat, fängt die gezüchtete Rubric. Kein einziger Fall läuft andersherum.
Falsch durchwinken schickt einen kaputten Agenten in Produktion. Falsch durchfallen kostet einen Retry. Deshalb ist die Richtung der Fehler wichtiger als die Summe. Das ist keine große Weisheit. Im Schulhof wusste man das schon. Bei Agenten hat man es eine Weile verdrängt.
Kleines Setting, ein eingefrorenes 7B-Modell als Agent und Judge. Labor. Aber die Richtung gefällt mir: nicht noch einmal die Weights anfassen, sondern den Zettel, nach dem benotet wird.
Quellen
Bis bald
Euer Benny