Wenn ein Modell sich irrt und dabei selbstsicher klingt, denken viele: einmal nachhaken, dann kippt es. Akira Okutomi sagt in einem Workshop-Paper zu ICML: nicht unbedingt. Manche Fehler sitzen fest.
Er nennt das stable miscalibration. Das Modell ist lokal ruhig – kleine Störung am Prompt, die Antwort bleibt. Nur halt falsch. Wie ein Schachspieler, der nach drei Zügen immer noch dieselbe schlechte Idee hat und dabei immer sicherer wirkt.
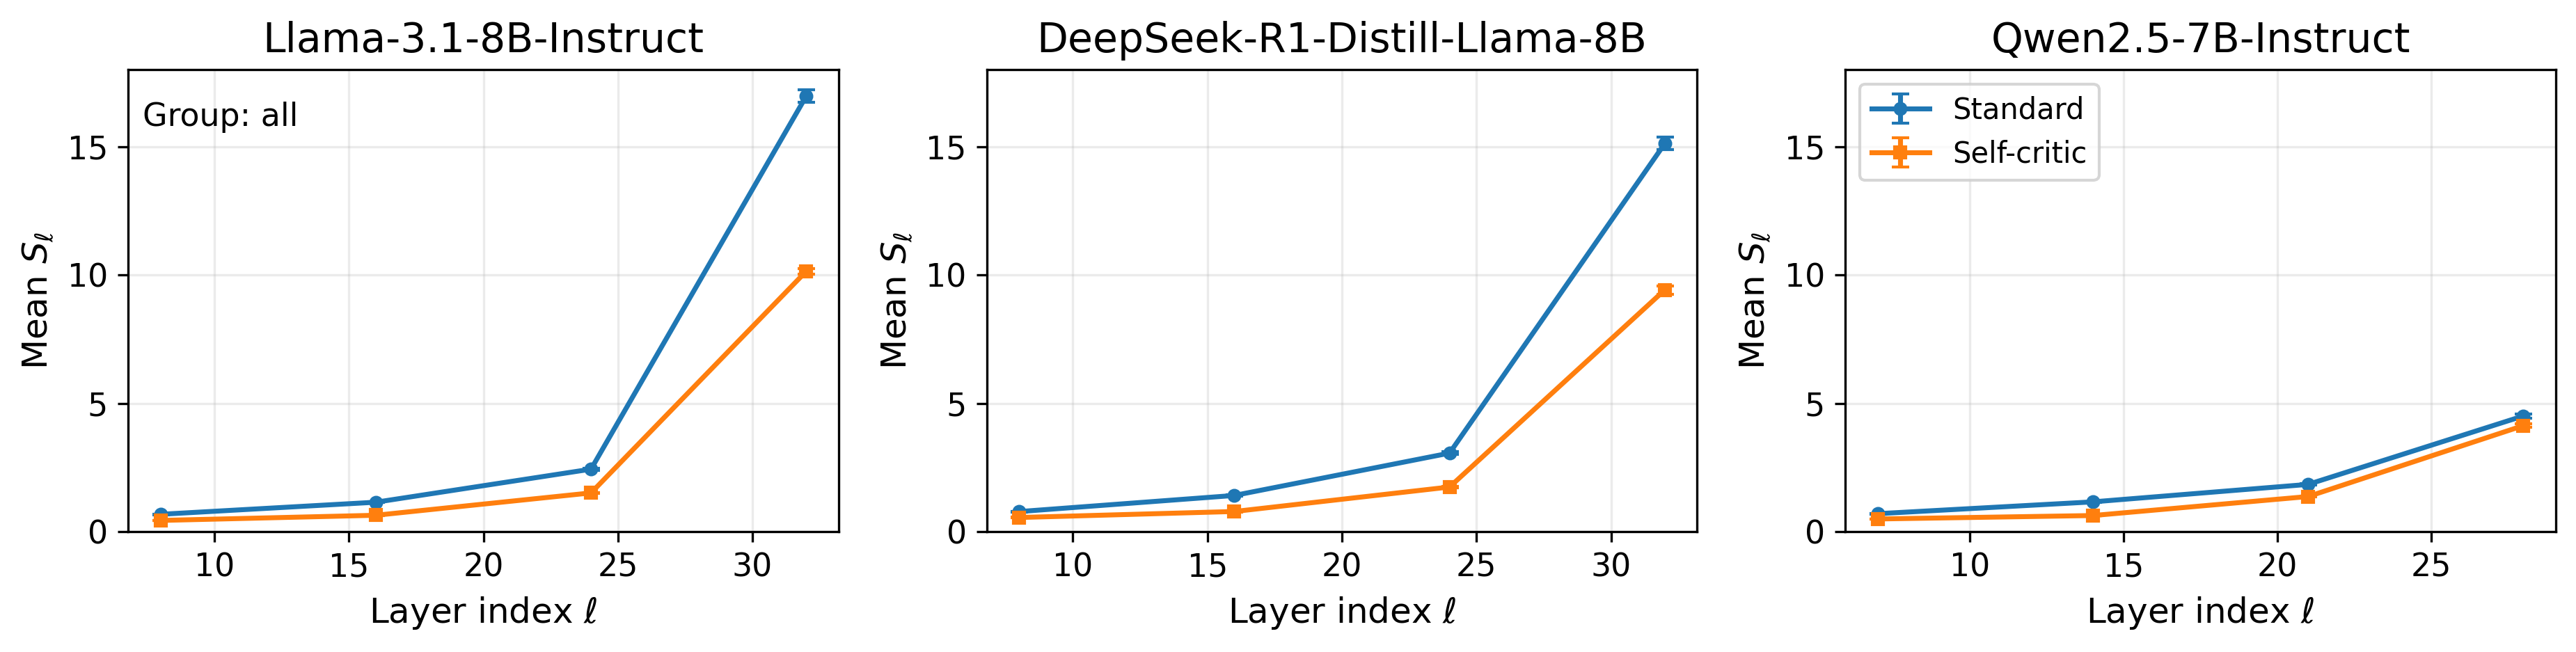
Gemessen hat er das auf 532 Ja/Nein-Fakten in elf Bereichen. Oben, beim Output, mit gpt-4.1-mini. Unten, in den Hidden States, mit drei open-weight Modellen: Llama-3.1-8B-Instruct, DeepSeek-R1-Distill-Llama-8B und Qwen2.5-7B-Instruct.
Self-Critique, also der Prompt „prüf dich nochmal“, macht die Hidden States tatsächlich ruhiger. Die Kurve geht runter, in allen drei Modellen. Klingt nach Fortschritt. Ist es nur halb. Die sicher-falschen Antworten sind innen nicht wackliger als die sicher-richtigen. Man kann sie also nicht an der Zappeligkeit erkennen. Das Modell wird stiller. Richtiger wird es davon nicht.
Praktisch heißt das: Wer dem Modell nur „sei unsicher, wenn du unsicher bist“ zuruft, beruhigt oft nur den Motor. Die falsche Überzeugung bleibt sitzen. Okutomi selbst sagt, das ist ein Audit, kein Live-Filter. Kleines Set, keine große Public Bench. Trotzdem eine nützliche Unterscheidung: zerbrechlich falsch und fest falsch sind zwei verschiedene Tiere.
Quellen
Bis bald
Euer Benny