Am Wochenende legt arXiv keine neue Welle vor. Drei Preprints vom Freitag sind aber noch nicht hier gelandet. Sie messen, was Agenten und Roboter können, wenn die Aufgabe nicht mehr der gewohnte Übungszettel ist.
Der Übungsplatz ändert sich mit
Programme, die selbst Werkzeuge bedienen und über viele Schritte an einer Aufgabe bleiben, heißen Agenten. Sie trainieren in einer Welt mit festen Regeln: einer Website, einem Code-Archiv, einer simulierten Küche. Sobald der Agent die Aufgaben löst, gibt diese Welt nichts Neues mehr her.
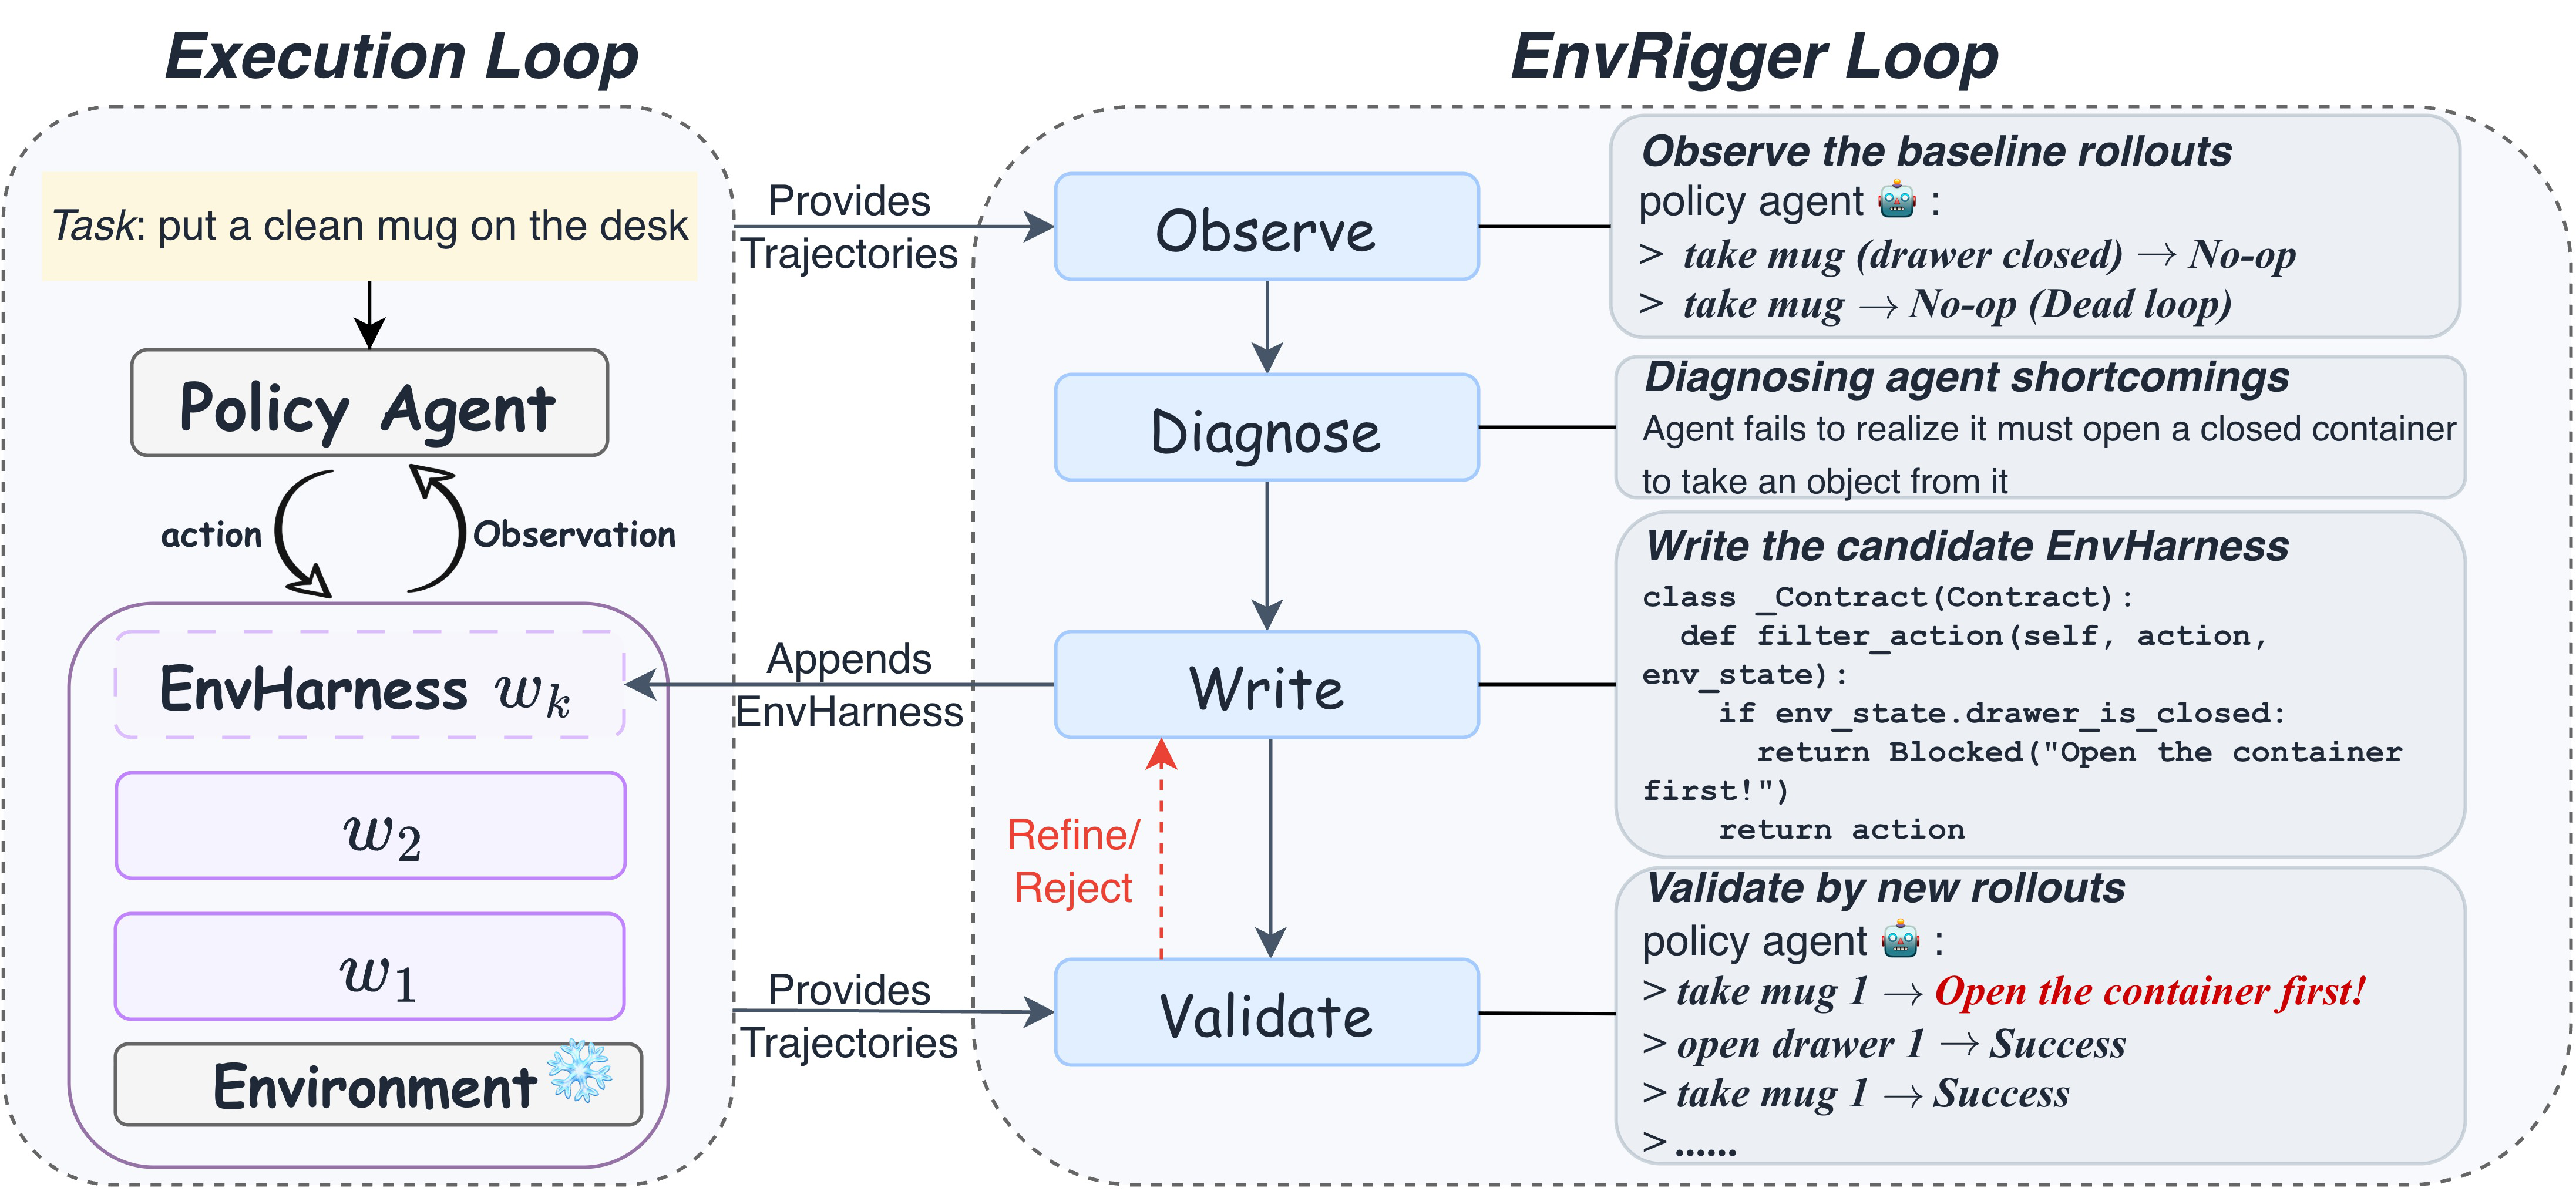
Ein Team von Google Cloud AI Research und der Washington University in St. Louis wickelt solche Welten in eine zusätzliche Schicht. EnvHarness ändert Startzustände, Regeln und Rückmeldungen, ohne den Kern und die Prüffunktion anzufassen. Ein zweites Programm, EnvRigger, schaut dem Agenten zu, benennt eine Schwäche und schreibt eine Schicht dagegen. Im Beispiel: Der Agent greift nach einer Tasse in einer geschlossenen Schublade. Die Schicht blockiert den Griff und verlangt zuerst das Öffnen.
Auf gehaltenen Testaufgaben steigt die Trefferquote um bis zu neun Punkte, bei knapp zehn Prozent weniger Schritten. Beim Programmiertest SWE-bench Verified klettert ein Agent über drei Runden von 47,7 auf 54,8 Prozent, in der simulierten Haushaltswelt ALFWorld von 61,7 auf 68,3. Code und Projektseite sind offen. Ob die Schichten in der echten Welt halten, zeigt das Papier nicht.
Neue Roboteraufgaben ohne neue Fernsteuerung
Bei Google DeepMind steht ein anderes Problem: Steuerungsmodelle, die Kamerabilder und Sprachbefehle in Roboterbewegungen übersetzen, lernen meist, indem ein Mensch den Arm stundenlang per Fernbedienung führt. Eximo soll das für neue Aufgaben ersetzen. Ein Bild-Sprach-Modell zerlegt den Auftrag in Schritte, die das vorhandene Bewegungsmodell schon kann – etwa „nimm den blauen Teller mit der linken Hand“. Erfolgreiche Durchläufe werden ins Bewegungsmodell zurückgeschrieben. Danach korrigiert ein kleines Zusatzprogramm die Bewegungen, indem es Erfolg und Misserfolg ausprobiert.
Getestet wurde das in der Simulation, auf der offenen Zwei-Arm-Plattform ALOHA, mit 22 Aufgaben: Teller und Schüssel ins Regal, Stift in den Behälter, Werkzeug in die richtige Fachseite. Das Basismodell ist die 3-Milliarden-Parameter-Variante von Gemini Robotics On-Device. Die Zerlegung sammelt mehr erfolgreiche Versuche als das Bewegungsmodell allein. Nach dem Zurückschreiben löst das Modell die Aufgabe selbst, ohne das Planungsmodell bei jedem Schritt zu fragen. Das Papier bleibt in der Simulation; einen echten Roboter hat es nicht gezeigt.
Wissenschaftscode: öffentliche Tests täuschen
Fudan und das Shanghai Innovation Institute fragen in SWE-bench Science, ob Programmieragenten wissenschaftlichen Code reparieren. 119 Aufgaben aus 98 GitHub-Archiven, 20 Fächer, im Mittel rund 80.000 Zeilen Kontext. Öffentliche Tests darf der Agent sehen, versteckte wissenschaftliche Fälle nicht.
Der beste Lauf – Claude Code mit Opus-5 – besteht 47,9 Prozent der Aufgaben vollständig. Dieselbe Konfiguration kommt bei den öffentlichen Tests auf 96,6 Prozent. GPT-5.6 Sol liegt bei 46,2 Prozent vollständigen Treffern und 99,2 Prozent öffentlichen Tests. Der Abstand ist die Meldung: Der sichtbare Test wird grün, die physikalische oder chemische Bedingung dahinter nicht. Typische Fehler: falsche Fachannahme, Flickwerk am Symptom, eine Datei repariert und den Rest des Systems vergessen. Zusätzliche Fachhinweise helfen nicht immer: Bei GPT-5.6 Sol sank die vollständige Trefferquote, bei DeepSeek-V4-Flash stieg sie.
Bis bald
Euer Benny